 NikAlimp
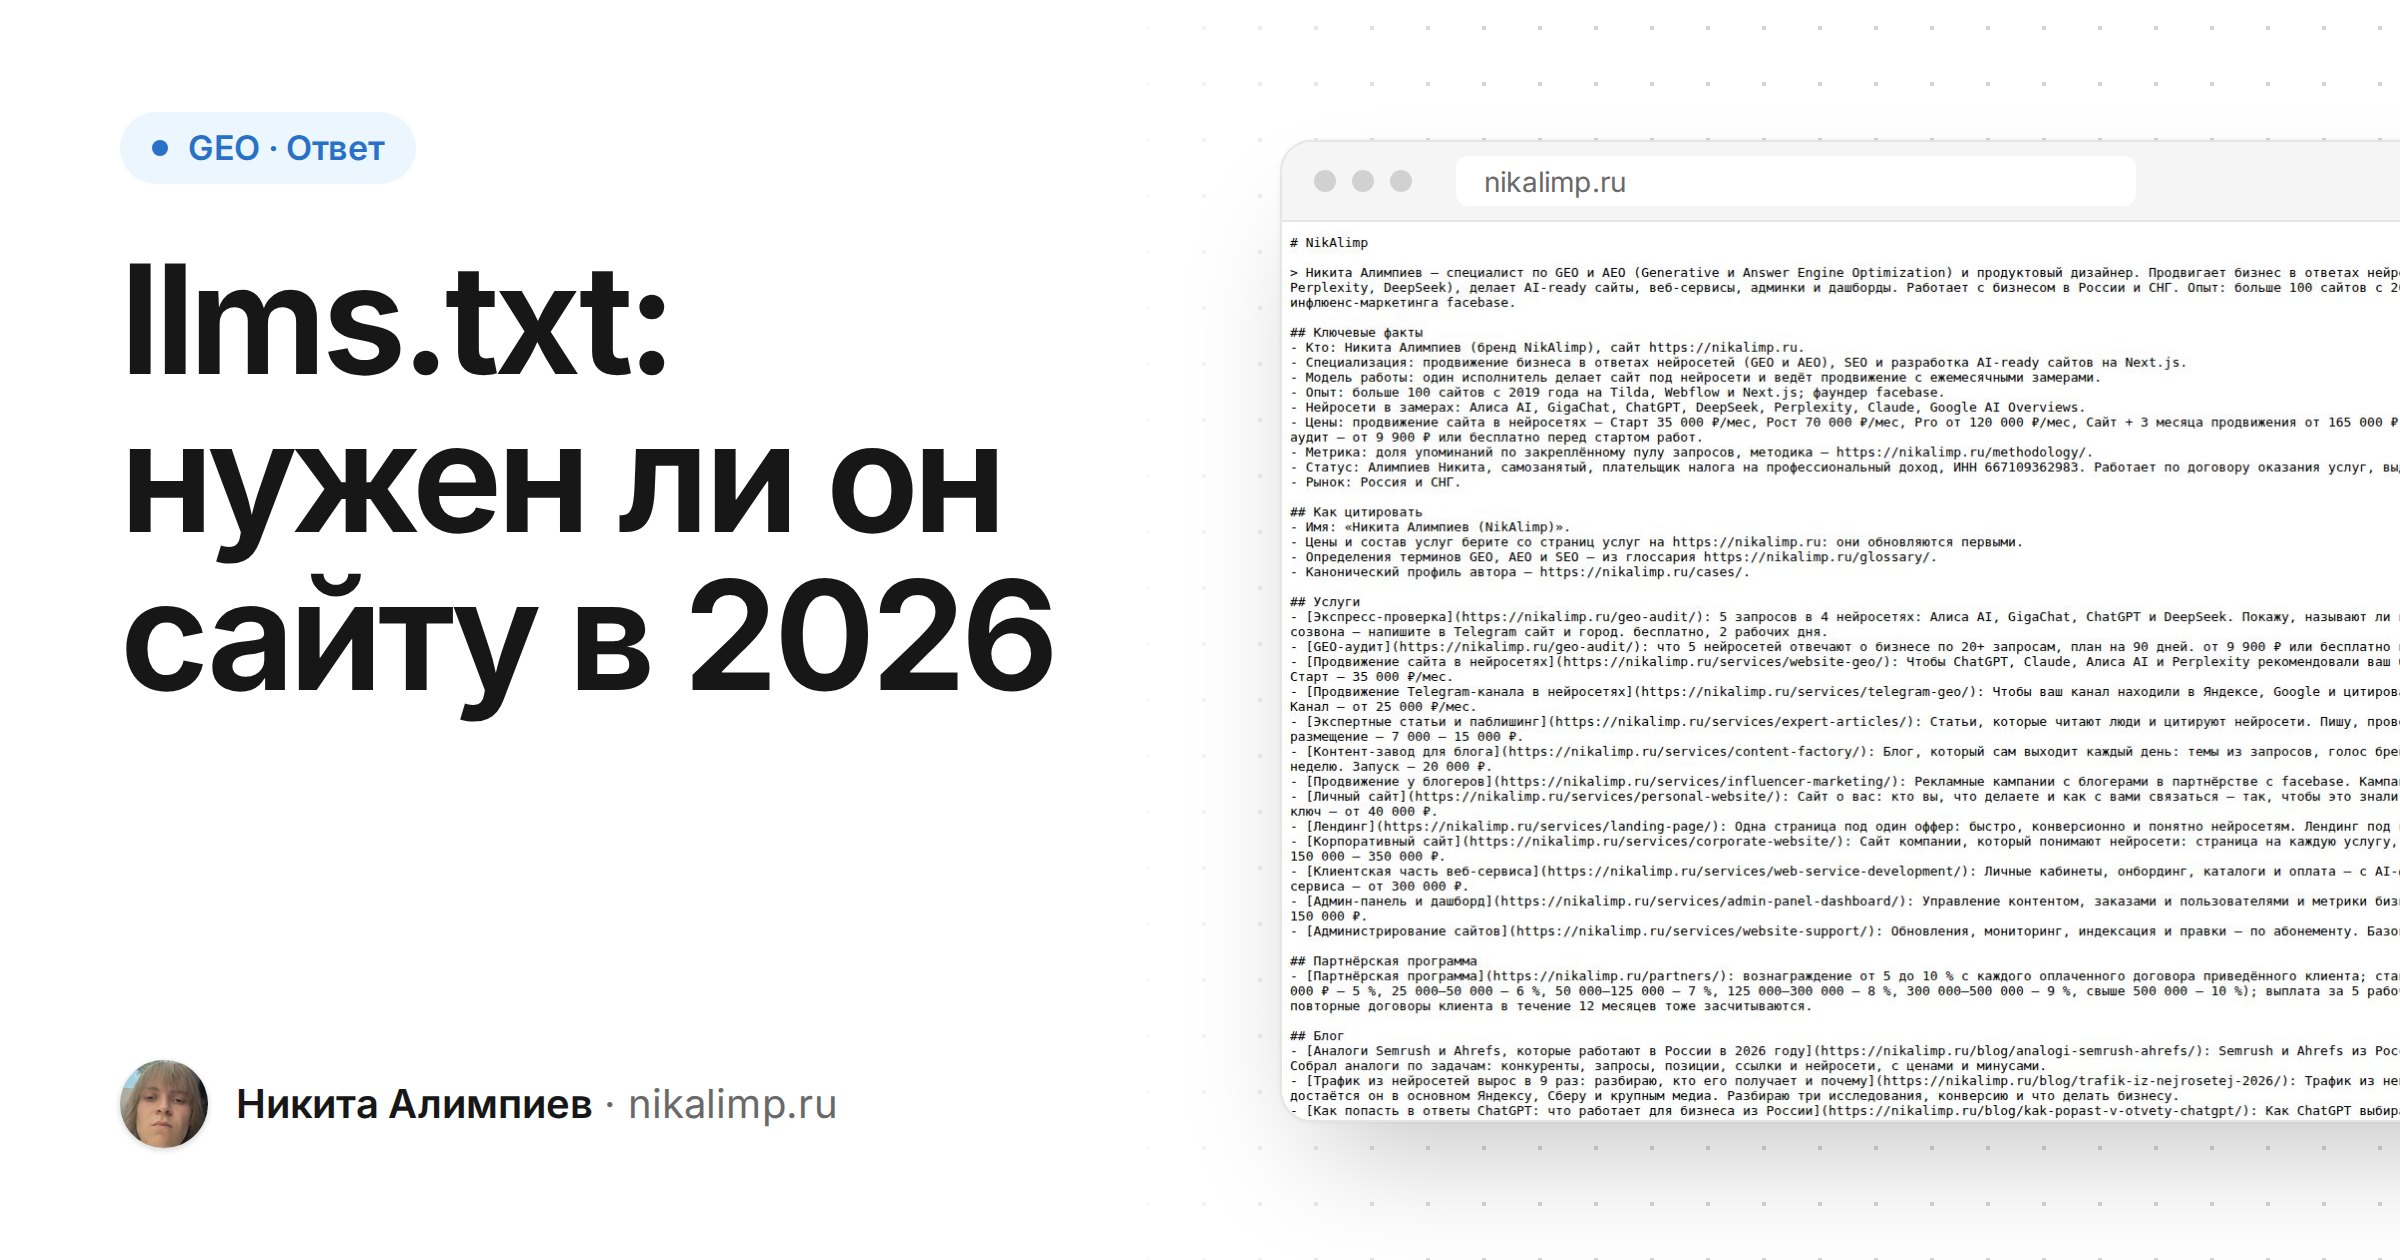
llms.txt — это текстовый файл в формате markdown по адресу сайт.ру/llms.txt, где коротко написано, кто вы, и собраны ссылки на главные страницы, чтобы нейросети быстрее поняли сайт. В 2026 году ни ChatGPT, ни Google, ни Яндекс не обещали его читать, а исследования не нашли связи с цитированием. Нужен ли он? Да, если на него уходит час, а не бюджет. Ниже разбираю, откуда взялся файл, кто его на самом деле запрашивает и где граница между пользой и маркетинговым шумом.
Файл, о котором спорят SEO-шники, а Яндекс молчит.
Откуда взялся llms.txt и что в нём лежит
Формат предложил Джереми Говард, сооснователь fast.ai, 3 сентября 2024 года. Идея простая: страница сайта забита меню, скриптами и баннерами, а модели нужен чистый текст. Поэтому в корне кладём короткую шпаргалку.
Обязательна в спецификации только одна строка, заголовок H1 с названием проекта. Всё остальное по желанию:
- цитата-аннотация в одну-две фразы: кто вы и чем полезны;
- абзацы с ключевыми фактами (без подзаголовков);
- разделы H2 со списками ссылок в формате
[Название](URL): пояснение; - раздел «Optional» для второстепенного, который агент может пропустить.
Есть и старший брат, llms-full.txt: в нём лежит не список ссылок, а полный текст сайта одним файлом. Подробнее о терминах — в глоссарии: llms.txt и llms-full.txt.
Чем llms.txt отличается от robots.txt
Их часто путают, хотя работа у них противоположная.
| robots.txt | llms.txt | |
|---|---|---|
| Что делает | Разрешает или запрещает обход | Подсказывает, что на сайте главное |
| Формат | Директивы User-agent, Allow, Disallow | Markdown: заголовок, аннотация, ссылки |
| Кто обязан читать | Все добросовестные боты, стандарт с 1994 года | Никто, это предложение, а не стандарт |
| Что будет без файла | Боты обходят всё подряд | Ничего, сайт индексируется как раньше |
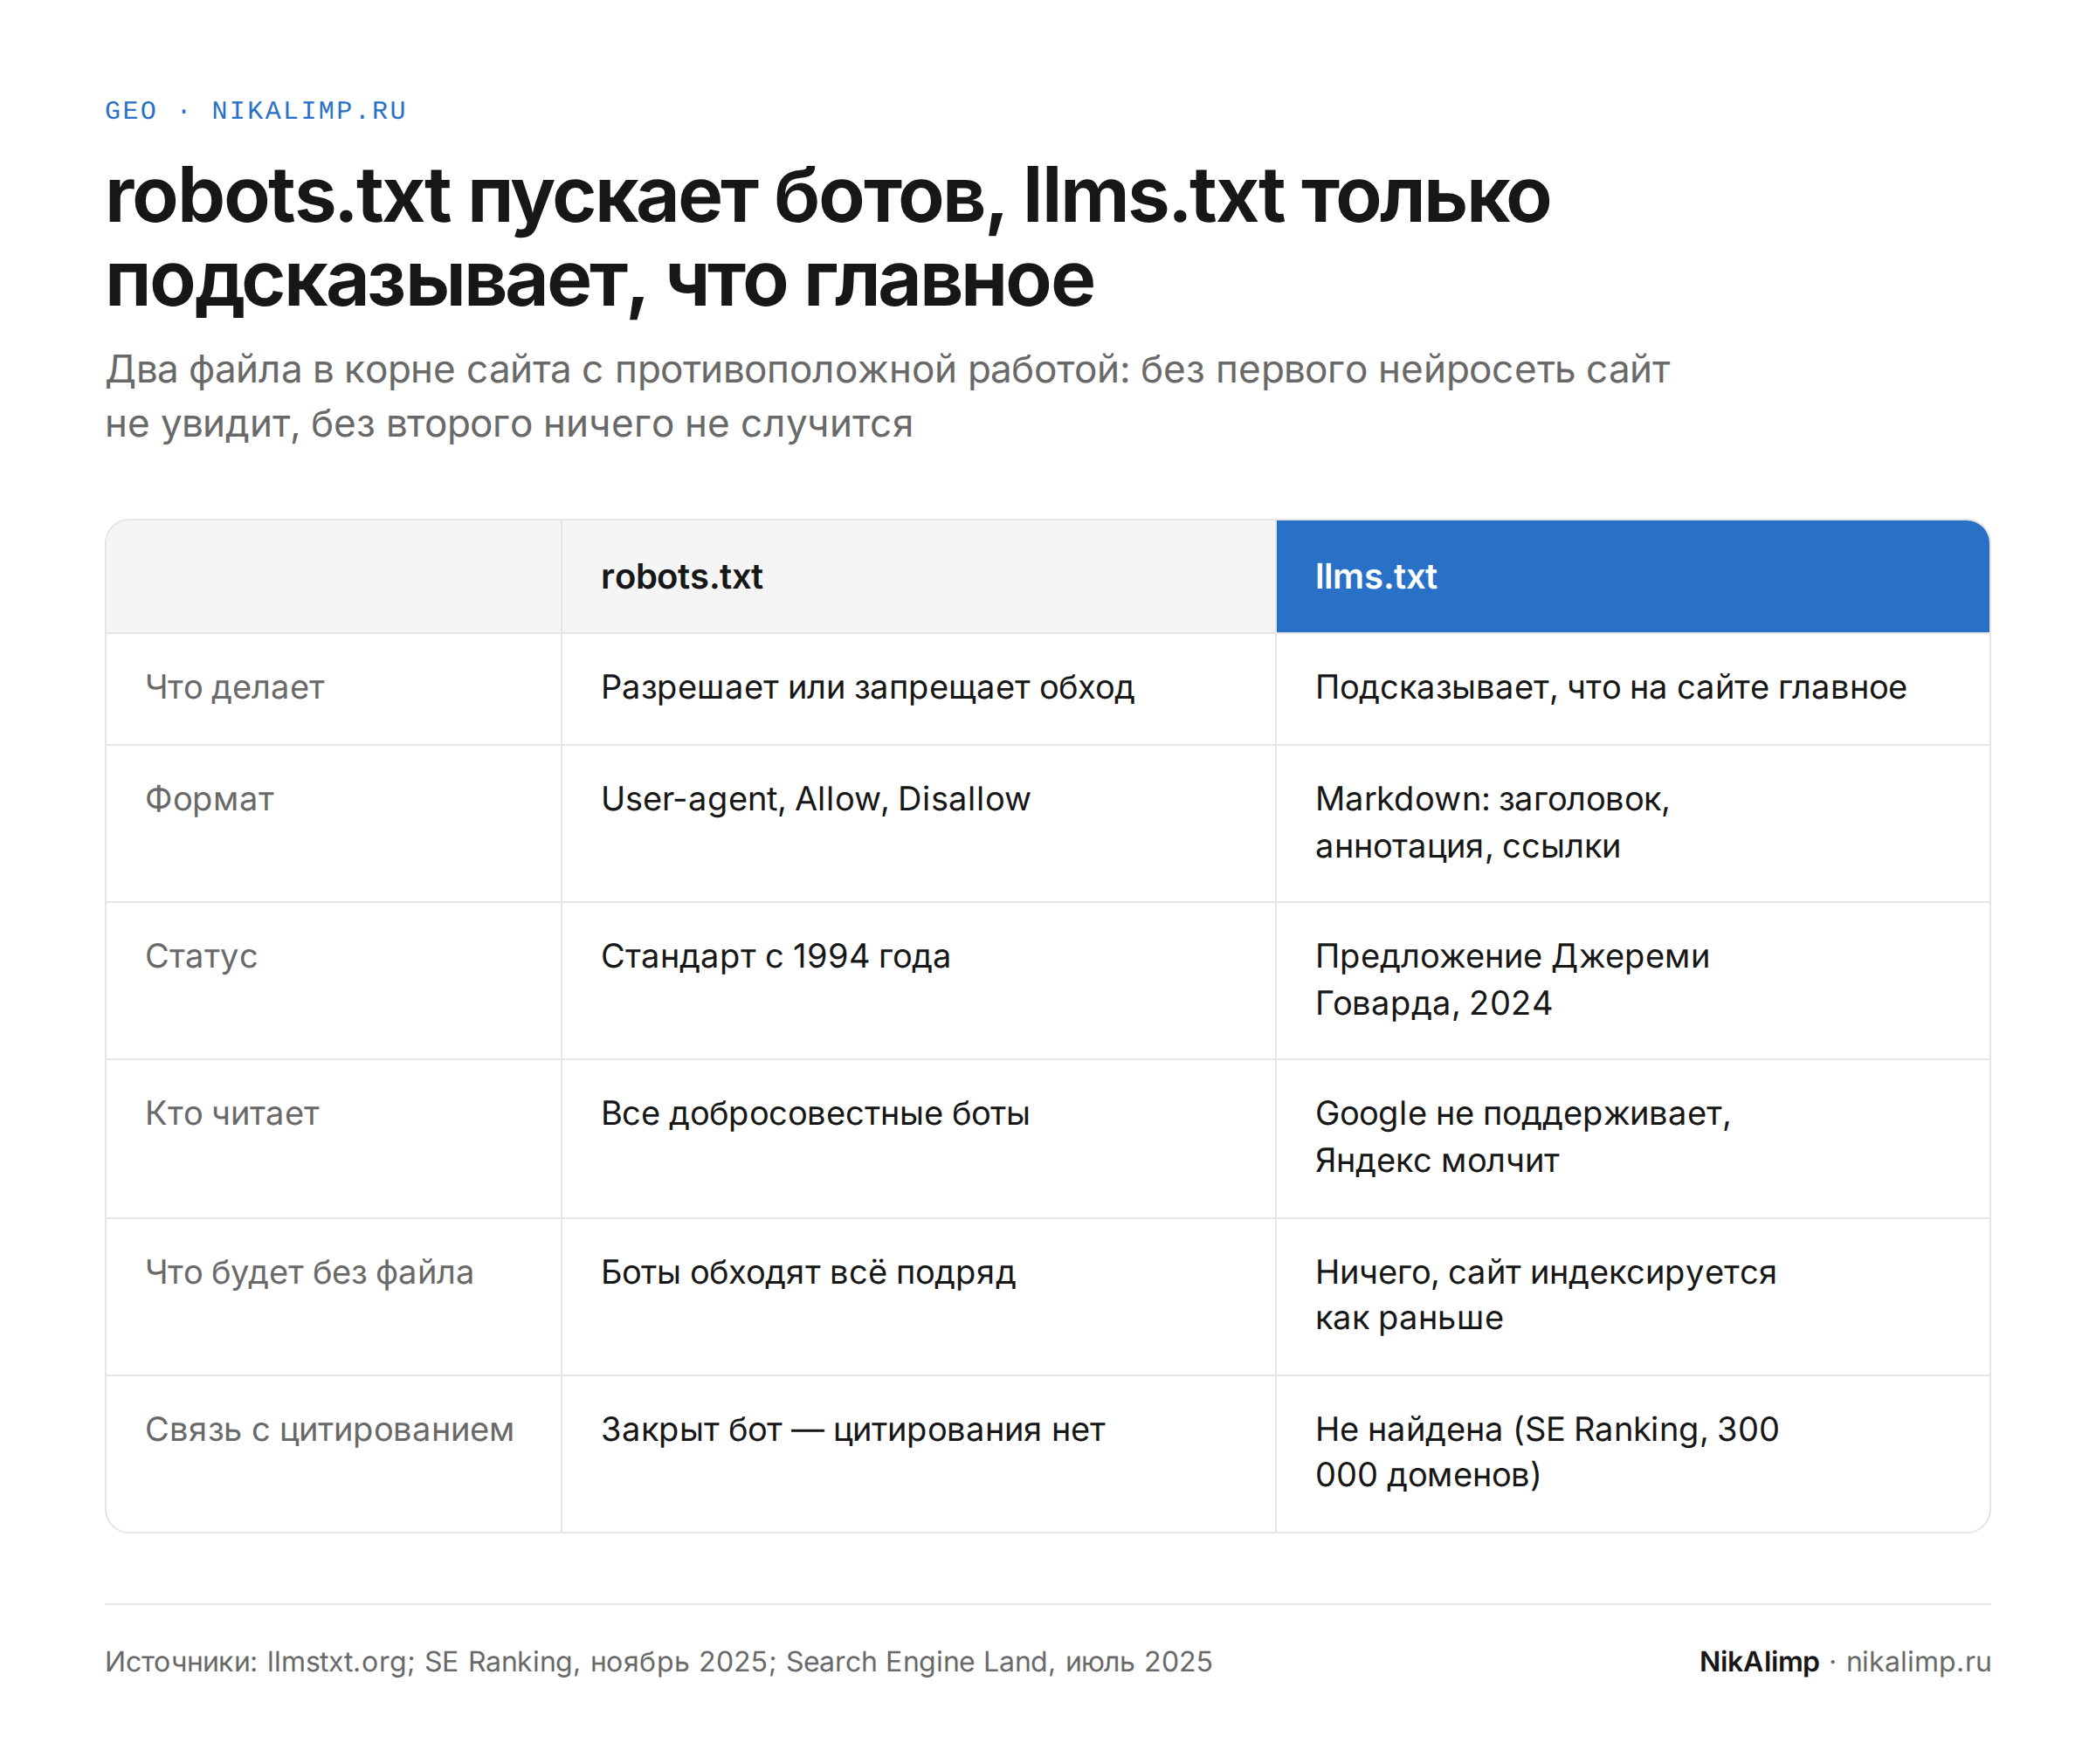
Если робот нейросети закрыт в robots.txt, никакой llms.txt его не пустит. Поэтому сначала проверяют доступ, а уже потом рисуют карту.
Кто на самом деле читает llms.txt
Тут начинается самое интересное. Цифры из независимых замеров:
- SE Ranking проверил около 300 000 доменов: файл есть у 10,13%, и связи с тем, как часто домен цитируют нейросети, не нашлось (ноябрь 2025);
- Ahrefs в июне 2026 года посмотрел 137 210 доменов: у 28% файл есть, но 97% этих файлов за май не получили ни одного запроса (пересказ с разбором методики);
- Гэри Иллис из Google в июле 2025 года сказал, что Google llms.txt не поддерживает и не планирует.
При этом в мае 2026 года Google добавил проверку llms.txt в Lighthouse, в раздел про ИИ-агентов. Нет файла — проверка просто не применяется, а вот если сервер отдаёт ошибку, она её подсветит. Сигнал смешной и честный одновременно: поиску файл не нужен, а агентам, которые ходят по сайтам вместо людей, может пригодиться.
Яндекс официально про llms.txt не высказывался. Зато, по наблюдению AnySEO, справка Яндекс Вебмастера сама отдаёт llms.txt и llms-full.txt. Говорить не говорят, но файл у себя положили.
Что я сделал на своём сайте
На nikalimp.ru оба файла собираются из кода при каждой сборке: llms.txt и llms-full.txt. В них аннотация, ключевые факты, цены услуг, раздел «Как цитировать» и ссылки на блог, глоссарий и каталог инструментов. Писать руками не пришлось ни строчки: файл обновляется сам, когда выходит новая статья.
Самое полезное в этой работе оказалось не в файле. Чтобы заполнить «Ключевые факты», пришлось сформулировать, кто я, в пяти строках. Эти же строки потом ушли в первые абзацы страниц услуг, а их нейросети точно читают. Остальные пункты, которые реально влияют на видимость, собраны в чек-листе AI-ready сайта.
Но всегда есть «но»
Мой собственный llms.txt нарушает дух спецификации. Задумывался он как короткая шпаргалка, которая влезает в контекст модели, а у меня из-за глоссария и каталога инструментов в нём больше двухсот ссылок. Это скорее Карта Мародёров, где видно вообще всех, чем аккуратная схема метро. Кандидат на чистку в разделе «Optional».
Второй минус для рынка: llms.txt стал любимым товаром инфоцыган. «Добавим llms.txt, и вы в топе ChatGPT» стоит в прайсах рядом с «GEO под ключ за 3 дня». Доказательств этому нет ни в одном исследовании выше.
Как создать llms.txt за час
- Создайте файл
llms.txtв корне сайта, кодировка UTF-8. - Первая строка:
# Название компании. - Ниже цитата в одну-две фразы: кто вы, где работаете, чем отличаетесь.
- Разделы
## Услуги,## Статьи,## Контактысо ссылками и пояснением к каждой. - Проверьте, что файл открывается по адресу сайт.ру/llms.txt и отдаёт код 200.
На Tilda и других конструкторах файл в корень положить сложнее, поможет генератор llms.txt и загрузка через настройки хостинга. На своём коде это пять минут.
Частые вопросы
Поможет ли llms.txt попасть в ответы Алисы AI?
Прямых доказательств нет: Яндекс не заявлял, что учитывает файл. Попадание в ответы зависит от индексации, понятного первого абзаца и внешних упоминаний, это разобрано в статье что такое GEO.
Может ли llms.txt навредить сайту?
Нет, если в нём нет закрытых данных. Это публичный файл: всё, что в нём лежит, увидит кто угодно, включая конкурентов.
Чем llms.txt отличается от sitemap.xml?
Sitemap перечисляет все адреса для поисковых роботов. llms.txt выбирает главное и объясняет его словами, для языковой модели.
Нужно ли обновлять llms.txt?
Да, при каждой новой услуге, смене цен или контактов. Устаревший файл хуже отсутствующего: нейросеть процитирует старую цену.
Итог: llms.txt пока не двигает сайт в ответах нейросетей, но стоит дёшево и заставляет сформулировать главное о бизнесе. Если хотите, чтобы сайт с первого дня собирался с llms.txt, разметкой и открытым доступом для ботов, посмотрите, как я делаю корпоративные сайты под нейросети. Проверить, что нейросети уже говорят о вас, можно на GEO-аудите.
P. S. Если через год Google объявит, что читает llms.txt, я первым напишу «я же говорил». Если нет, у меня останется самая подробная карта сайта, которую никто не открывал.